
Análise do QwenPaw (CoPaw): o agente pessoal de código aberto da Alibaba
O QwenPaw, antes CoPaw, é o agente Apache-2.0 da Alibaba que pode rodar totalmente offline. Opções de instalação, padrões de sandbox e telemetria, e para quem ele serve.
O QwenPaw é um assistente pessoal de código aberto da equipe AgentScope da Alibaba. Se você o conhecia como CoPaw, é o mesmo projeto: foi lançado como CoPaw em fevereiro de 2026 e renomeado para QwenPaw em abril de 2026, como explicam as notas da versão v1.1.0. Você ainda vai ver o nome antigo em guias mais velhos e no pacote copaw do PyPI. O repositório tinha 37.495 estrelas no GitHub quando verificamos em 8 de novembro de 2026.
O que é
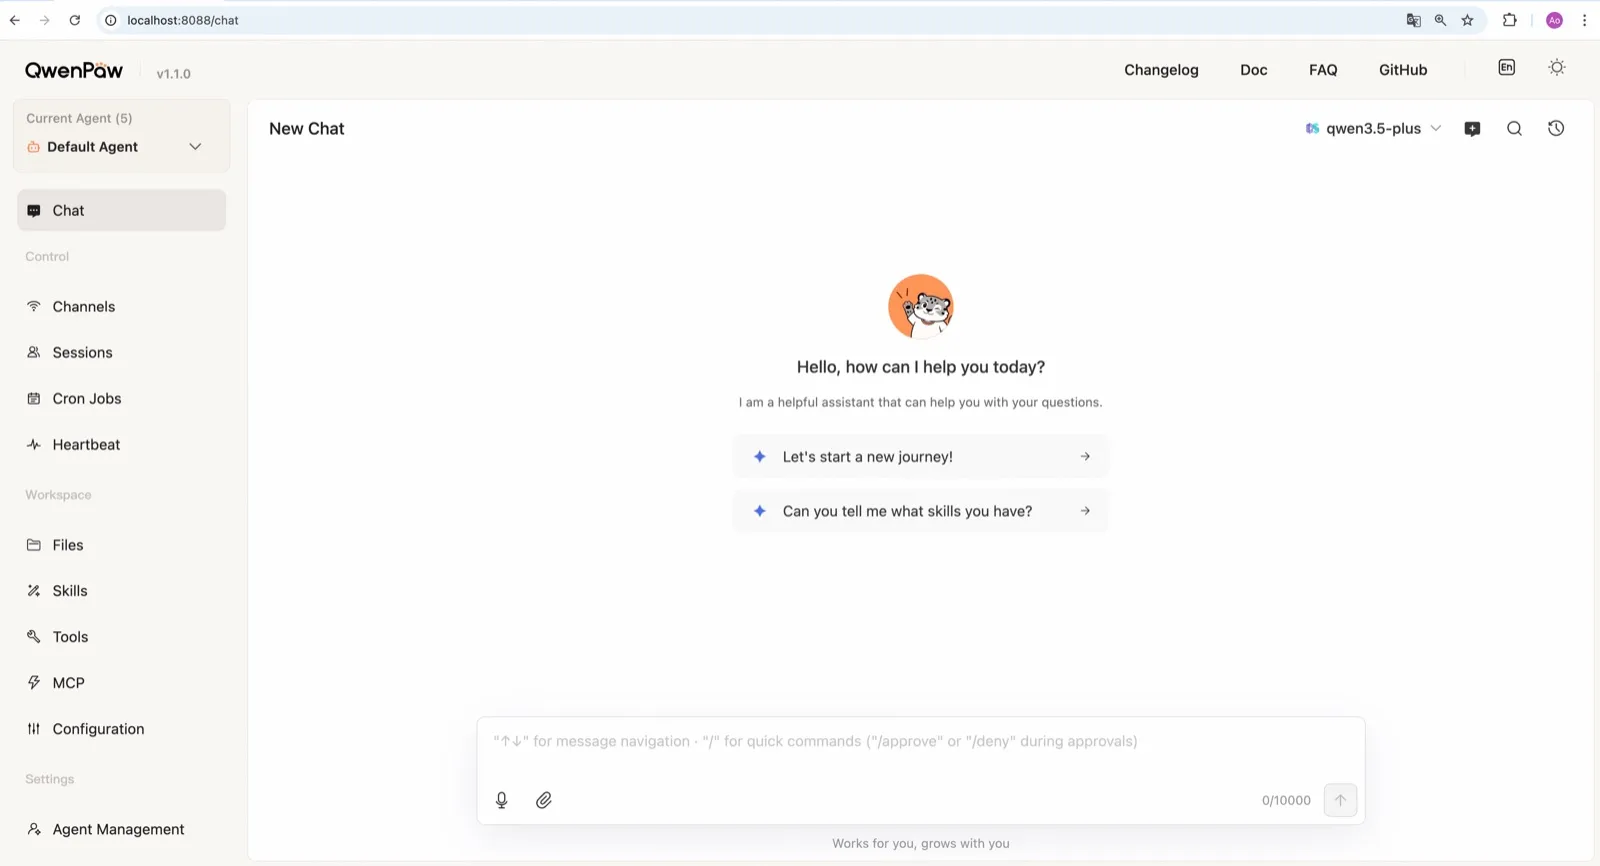
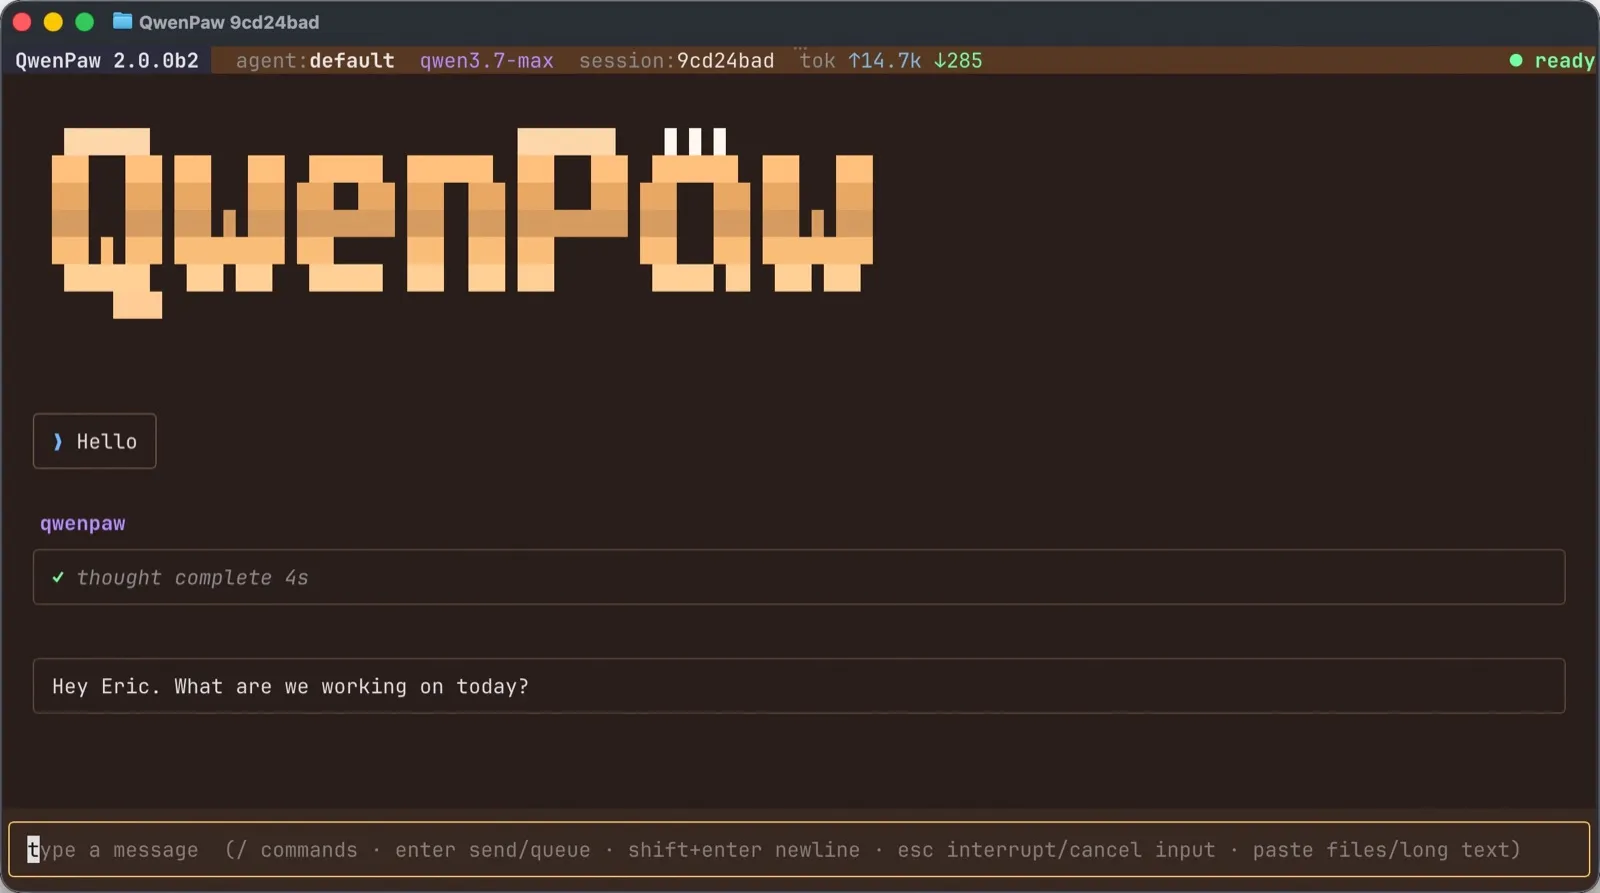
O QwenPaw é da mesma família do OpenClaw e do nanobot: um agente na sua máquina que você acessa por um console web, uma interface de terminal ou apps de chat, que se lembra de você, roda tarefas agendadas e pode agir por meio de um navegador, um shell, ferramentas MCP, skills e plugins. Duas coisas o diferenciam: ele foi feito para rodar inteiramente com modelos locais e pode executar vários agentes independentes lado a lado.
Instalação
Você pode instalar com pip (Python 3.11 a 3.13), um script de instalação ou Docker. O script é o caminho fácil: ele configura Python, Node.js e o console web no macOS, Linux ou Windows. A Alibaba também oferece deploy gratuito na nuvem com um clique na sua AgentScope Platform, embora isso já não seja auto-hospedagem. Existem apps de desktop para Windows e macOS, mas estão em beta.
O console web cobre canais, tarefas cron, heartbeat, skills, MCP e arquivos, e a documentação explica cada um. Os lançamentos são frequentes, com muitas betas, então conte com atualizar com frequência e ler as notas quando fizer isso.
Telemetria: leia o comando init
O QwenPaw envia dados anônimos de instalação uma vez por versão durante o qwenpaw init: versão, método de instalação, sistema operacional, versão do Python, arquitetura de CPU e se há GPU. A equipe diz que não coleta dados pessoais, arquivos, credenciais nem endereços IP (README).
O porém está em como o consentimento funciona. A configuração interativa pede que você aceite, mas o comando de início rápido que a documentação recomenda, qwenpaw init --defaults, aceita automaticamente. Se você não quer que nada seja enviado, rode o qwenpaw init interativo e recuse. São poucos dados, mas ficam ativados por padrão se você seguir o início rápido.
Sandbox: desativado, e mais fraco no Docker
O QwenPaw tem mais camadas de segurança do que a maioria dos agentes desta categoria. A documentação de segurança descreve Tool Guard, File Guard, verificação de skills, políticas de acesso e um sandbox opcional em nível de kernel para comandos.
Esse sandbox vem desativado por padrão (código-fonte), e dentro do Docker ele passa a não ter isolamento nenhum. Esse segundo ponto é contraintuitivo: rodar o QwenPaw no Docker não dá a você o sandbox de comandos, apenas a separação que o próprio contêiner oferece. Se você instalá-lo na sua máquina principal, ative o sandbox antes de conectar qualquer canal de chat.
Modelos locais são o ponto forte
O QwenPaw funciona com mais de 20 provedores na nuvem, incluindo DashScope (Qwen), OpenAI, Anthropic, Gemini, DeepSeek, Kimi e OpenRouter. Também pode rodar totalmente offline, sem chave de API: tem um runtime llama.cpp embutido, suporta Ollama e LM Studio, e a equipe publica seus próprios modelos pequenos QwenPaw-Flash treinados para tarefas de agente (documentação de modelos).
Essa combinação, um runtime e um modelo ajustado para ele vindos da mesma equipe, dá menos trabalho de configuração do que ligar você mesmo um agente a um servidor de modelos local separado. O que um modelo local consegue fazer ainda depende do seu hardware, então teste suas tarefas reais antes de abandonar um provedor na nuvem.
Vários agentes e memória
Cada agente tem a própria memória, skills e heartbeat, e os agentes podem trabalhar juntos (documentação multiagente). A memória é um armazenamento em Markdown de três camadas que você pode ler e editar. As verificações de heartbeat e as tarefas cron mantêm os agentes trabalhando enquanto você está fora. A geração de imagens vem por plugins oficiais para Qwen-Image ou GPT Image 2.
Canais
A cobertura é mais forte para plataformas chinesas: DingTalk, Feishu, WeChat e QQ, ao lado de Telegram, Discord e Slack. O iMessage só funciona num Mac com um helper de terceiros e Acesso Total ao Disco, que é uma permissão ampla para conceder. Não há canal de WhatsApp (documentação de canais).
Quem deveria usar
O QwenPaw atende quem quer um agente auto-hospedado que rode inteiramente com modelos locais, usuários de DingTalk, Feishu, WeChat ou QQ, e quem quer uma pequena equipe de agentes especialistas numa única máquina. É uma escolha mais fraca se você precisa de WhatsApp ou quer um sandbox ativo sem mexer nas configurações.
Como ele se compara
- O nanobot é o mais parecido: Python, MIT, uma WebUI caprichada, modelos locais e sem telemetria por padrão, embora o sandbox de shell dele também venha desativado.
- O ZeroClaw tem o sandbox do sistema operacional ativado no perfil recomendado e não envia telemetria, mas a configuração é um arquivo TOML.
- O OpenClaw tem o ecossistema maior e suporte a WhatsApp, com o sandbox desativado por padrão.
Veja melhores agentes de IA locais e alternativas ao OpenClaw para mais opções.
Preços
| Open source | Grátis |
|
|---|
Recursos
| Busca na web | Sim |
|---|---|
| Geração de imagens | Sim |
| Modo de voz | Sim |
| Envio de arquivos | Sim |
| Memória | Sim |
| Executa tarefas por você | Sim |
| Integrações com apps | Sim |
| Trabalha sozinho | Sim |
| Manda mensagem primeiro | Sim |
| Vários bots | Sim |
Pontos fortes
- Runs fully offline with a built-in llama.cpp runtime and purpose-trained QwenPaw-Flash models, no API key needed
- Several independent agents, each with its own memory, skills and heartbeat, that can work together
- Layered security: Tool Guard, File Guard, skill scanning, access policies and an optional kernel-level sandbox
- Broad chat coverage, especially for Chinese platforms such as DingTalk, Feishu, WeChat and QQ, alongside Telegram, Discord, Slack and iMessage
- Well-documented web console for channels, cron jobs, heartbeat, skills, MCP and files
Pontos fracos
- The command sandbox is off by default, and inside Docker it falls back to no isolation
- The recommended setup command accepts anonymous install telemetry automatically
- No WhatsApp channel, and iMessage works only on a Mac with a third-party helper and Full Disk Access
- Desktop apps are still in beta, and the project moves fast, with frequent beta releases
Ideal para
- People who want a self-hosted agent that can run entirely on local models
- Users of DingTalk, Feishu, WeChat or QQ who want an agent in those apps
- Running a small team of specialist agents on one machine
Fontes
- agentscope-ai/QwenPaw on GitHub (Apache-2.0, README with install options and telemetry)
- QwenPaw documentation
- QwenPaw v1.1.0 release notes: CoPaw rebrands to QwenPaw
- copaw on PyPI (first release February 2026)
- QwenPaw docs: Channels
- QwenPaw docs: Models (cloud providers, llama.cpp, Ollama, LM Studio)
- QwenPaw docs: Security (Tool Guard, File Guard, sandbox)
- QwenPaw source: security.sandbox_enabled defaults to off
- QwenPaw docs: Heartbeat
- QwenPaw docs: Multi-agent
- QwenPaw docs: Comparison (voice and video interaction)
- QwenPaw docs: Desktop application (beta)
- QwenPaw docs: Plugins (GPT Image 2 image generation plugin)
- QwenPaw Qwen-Image tool plugin (image generation and editing)