
Recenzja QwenPaw (CoPaw): open source'owy osobisty agent od Alibaby
QwenPaw, dawniej CoPaw, to agent Alibaby na licencji Apache-2.0, który może działać w pełni offline. Instalacja, sandbox, telemetria i dla kogo jest.
QwenPaw to open source’owy osobisty asystent od zespołu AgentScope w Alibabie. Jeśli ktoś znał go jako CoPaw, to ten sam projekt: wystartował jako CoPaw w lutym 2026, a w kwietniu 2026 zmienił nazwę na QwenPaw, jak wyjaśniają informacje o wydaniu v1.1.0. Starą nazwę wciąż widać w starszych poradnikach i w pakiecie copaw na PyPI. W dniu naszego sprawdzenia, 8 listopada 2026, repozytorium miało 37,495 gwiazdek na GitHubie.
Czym jest
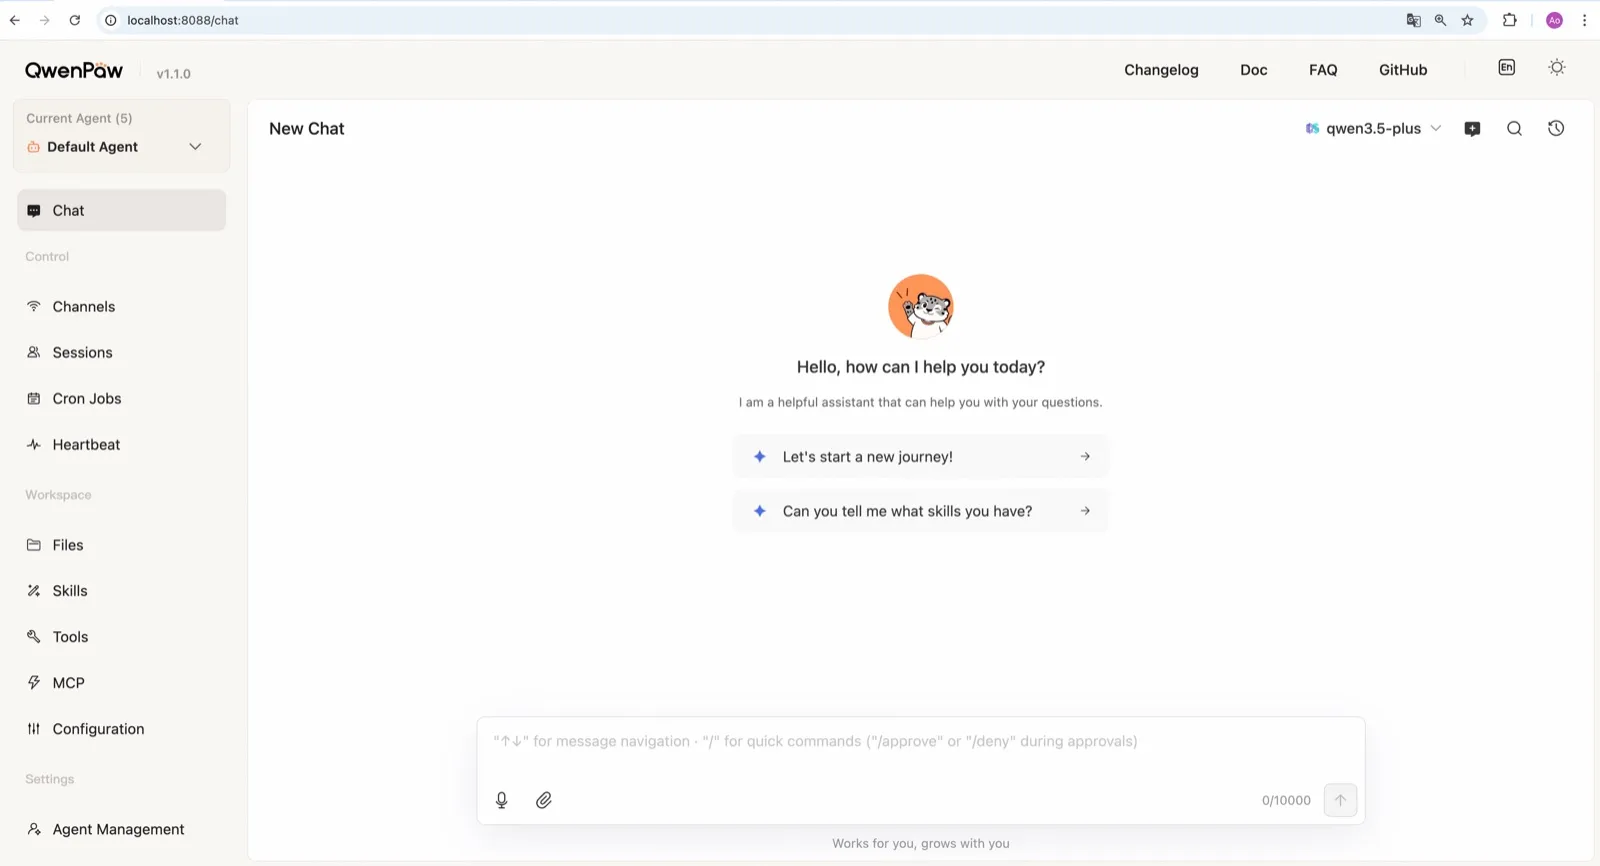
QwenPaw należy do tej samej rodziny co OpenClaw i nanobot: to agent na własnej maszynie, dostępny z konsoli webowej, interfejsu terminalowego lub aplikacji czatowych, który pamięta użytkownika, uruchamia zaplanowane zadania i może działać przez przeglądarkę, powłokę, narzędzia MCP, umiejętności i wtyczki. Wyróżniają go dwie rzeczy: jest zbudowany tak, by działać całkowicie na lokalnych modelach, i może uruchamiać kilku niezależnych agentów obok siebie.
Instalacja
Można go zainstalować przez pip (Python 3.11 do 3.13), skrypt instalacyjny lub Dockera. Skrypt to najprostsza droga: konfiguruje Pythona, Node.js i konsolę webową na macOS, Linuksie lub Windowsie. Alibaba oferuje też darmowe wdrożenie jednym kliknięciem w chmurze na swojej AgentScope Platform, choć to już nie jest samodzielne hostowanie. Aplikacje desktopowe na Windowsa i macOS istnieją, ale są w becie.
Konsola webowa obejmuje kanały, zadania cron, heartbeat, umiejętności, MCP i pliki, a dokumentacja omawia każdy z tych elementów. Wydania są częste, z wieloma betami, więc trzeba liczyć się z częstymi aktualizacjami i czytaniem informacji o wydaniach.
Telemetria: uwaga na polecenie init
QwenPaw podczas qwenpaw init wysyła raz na wersję anonimowe dane o instalacji: wersję, metodę instalacji, system operacyjny, wersję Pythona, architekturę procesora i informację o obecności GPU. Zespół deklaruje, że nie zbiera danych osobowych, plików, poświadczeń ani adresów IP (README).
Haczyk tkwi w sposobie wyrażania zgody. Interaktywna konfiguracja prosi o zgodę, ale polecenie szybkiego startu zalecane w dokumentacji, qwenpaw init --defaults, akceptuje ją automatycznie. Aby nic nie było wysyłane, należy uruchomić interaktywne qwenpaw init i odmówić. To niewielka ilość danych, ale przy szybkim starcie zgodnym z dokumentacją jest to domyślnie włączone.
Sandboxing: wyłączony, a w Dockerze słabszy
QwenPaw ma więcej warstw bezpieczeństwa niż większość agentów w tej kategorii. Dokumentacja bezpieczeństwa opisuje Tool Guard, File Guard, skanowanie umiejętności, polityki dostępu i opcjonalny sandbox na poziomie jądra dla poleceń.
Ten sandbox jest domyślnie wyłączony (źródło), a w Dockerze w ogóle nie zapewnia izolacji. Ten drugi punkt jest sprzeczny z intuicją: uruchomienie QwenPaw w Dockerze nie daje sandboksa poleceń, a jedynie taką separację, jaką zapewnia sam kontener. Przy instalacji na głównej maszynie warto włączyć sandbox przed podłączeniem jakiegokolwiek kanału czatowego.
Lokalne modele to mocna strona
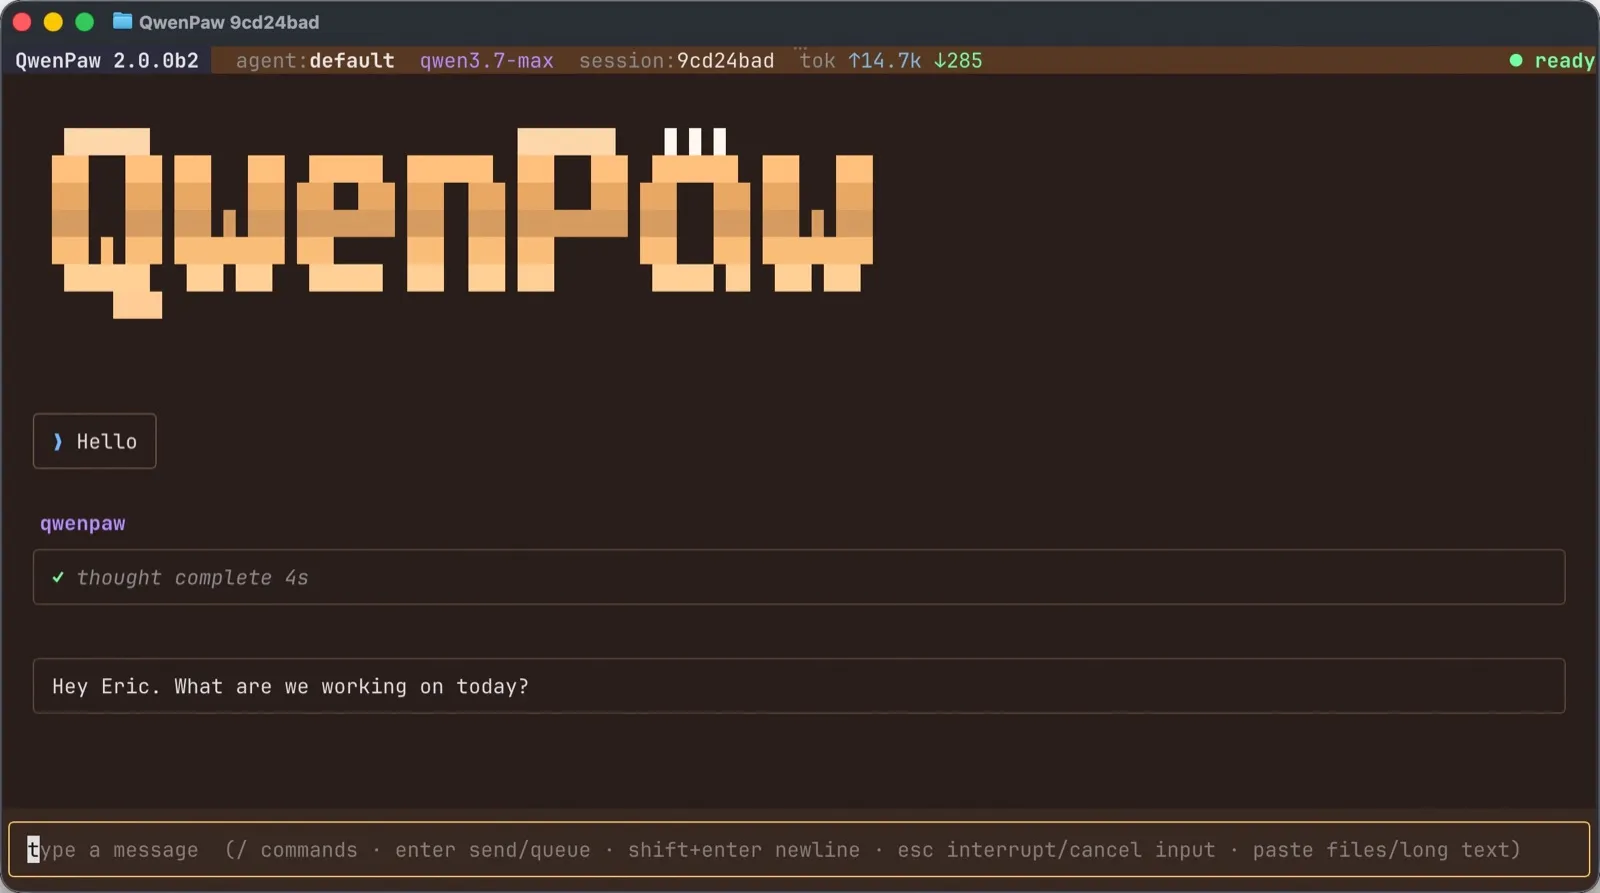
QwenPaw współpracuje z ponad 20 dostawcami chmurowymi, w tym DashScope (Qwen), OpenAI, Anthropic, Gemini, DeepSeek, Kimi i OpenRouter. Może też działać w pełni offline bez klucza API: ma wbudowane środowisko llama.cpp, obsługuje Ollama i LM Studio, a zespół publikuje własne małe modele QwenPaw-Flash trenowane do zadań agentowych (dokumentacja modeli).
To połączenie, czyli środowisko uruchomieniowe i dostrojony do niego model od tego samego zespołu, wymaga mniej konfiguracji niż samodzielne łączenie agenta z osobnym lokalnym serwerem modeli. To, z czym poradzi sobie lokalny model, nadal zależy od sprzętu, więc przed rezygnacją z dostawcy chmurowego warto sprawdzić go na realnych zadaniach.
Wielu agentów i pamięć
Każdy agent ma własną pamięć, umiejętności i heartbeat, a agenci mogą ze sobą współpracować (dokumentacja multi-agent). Pamięć to trzywarstwowy magazyn w Markdown, który można czytać i edytować. Okresowe meldunki heartbeat i zadania cron sprawiają, że agenci pracują pod nieobecność użytkownika. Generowanie obrazów zapewniają oficjalne wtyczki do Qwen-Image lub GPT Image 2.
Kanały
Najlepiej obsługiwane są chińskie platformy: DingTalk, Feishu, WeChat i QQ, obok Telegrama, Discorda i Slacka. iMessage działa tylko na Macu z pomocniczym narzędziem od zewnętrznego autora i uprawnieniem Full Disk Access, czyli bardzo szerokim dostępem. Kanału WhatsApp nie ma (dokumentacja kanałów).
Dla kogo jest
QwenPaw pasuje osobom, które chcą samodzielnie hostowanego agenta działającego całkowicie na lokalnych modelach, użytkownikom DingTalk, Feishu, WeChat lub QQ oraz każdemu, kto chce mieć na jednej maszynie mały zespół wyspecjalizowanych agentów. Jest słabszym wyborem, jeśli potrzebny jest WhatsApp albo sandbox włączony bez grzebania w ustawieniach.
Jak wypada na tle innych
- nanobot jest najbliższym odpowiednikiem: Python, MIT, dopracowany WebUI, lokalne modele i domyślnie brak telemetrii, choć jego sandbox powłoki również jest domyślnie wyłączony.
- ZeroClaw ma sandbox systemu operacyjnego włączony w zalecanym profilu i nie wysyła telemetrii, ale konfiguracja to plik TOML.
- OpenClaw ma większy ekosystem i obsługę WhatsAppa, przy domyślnie wyłączonym sandboxingu.
Więcej w zestawieniach najlepszych lokalnych agentów AI i alternatyw dla OpenClaw.
Ceny
| Open source | Za darmo |
|
|---|
Funkcje
| Wyszukiwanie w sieci | Tak |
|---|---|
| Generowanie obrazów | Tak |
| Tryb głosowy | Tak |
| Przesyłanie plików | Tak |
| Pamięć | Tak |
| Wykonuje zadania za ciebie | Tak |
| Integracje z aplikacjami | Tak |
| Działa samodzielnie | Tak |
| Pisze pierwszy | Tak |
| Wiele botów | Tak |
Mocne strony
- Runs fully offline with a built-in llama.cpp runtime and purpose-trained QwenPaw-Flash models, no API key needed
- Several independent agents, each with its own memory, skills and heartbeat, that can work together
- Layered security: Tool Guard, File Guard, skill scanning, access policies and an optional kernel-level sandbox
- Broad chat coverage, especially for Chinese platforms such as DingTalk, Feishu, WeChat and QQ, alongside Telegram, Discord, Slack and iMessage
- Well-documented web console for channels, cron jobs, heartbeat, skills, MCP and files
Słabe strony
- The command sandbox is off by default, and inside Docker it falls back to no isolation
- The recommended setup command accepts anonymous install telemetry automatically
- No WhatsApp channel, and iMessage works only on a Mac with a third-party helper and Full Disk Access
- Desktop apps are still in beta, and the project moves fast, with frequent beta releases
Najlepszy dla
- People who want a self-hosted agent that can run entirely on local models
- Users of DingTalk, Feishu, WeChat or QQ who want an agent in those apps
- Running a small team of specialist agents on one machine
Źródła
- agentscope-ai/QwenPaw on GitHub (Apache-2.0, README with install options and telemetry)
- QwenPaw documentation
- QwenPaw v1.1.0 release notes: CoPaw rebrands to QwenPaw
- copaw on PyPI (first release February 2026)
- QwenPaw docs: Channels
- QwenPaw docs: Models (cloud providers, llama.cpp, Ollama, LM Studio)
- QwenPaw docs: Security (Tool Guard, File Guard, sandbox)
- QwenPaw source: security.sandbox_enabled defaults to off
- QwenPaw docs: Heartbeat
- QwenPaw docs: Multi-agent
- QwenPaw docs: Comparison (voice and video interaction)
- QwenPaw docs: Desktop application (beta)
- QwenPaw docs: Plugins (GPT Image 2 image generation plugin)
- QwenPaw Qwen-Image tool plugin (image generation and editing)